 XIA LEI
自注意力机制:完整学习指南
引言
自注意力(Self-Attention)是驱动现代 Transformer 架构和大语言模型的核心机制。本指南将带你从零基础到精通。
什么是自注意力?
自注意力让序列中的每个词都能关注其他所有词,从而构建丰富的上下文表示。该机制会计算:
- 查询(Query,Q):我在寻找什么信息?
- 键(Key,K):我包含什么信息?
- 值(Value,V):我实际传递什么信息?
数学基础
自注意力的公式为:
Attention(Q, K, V) = softmax(QK^T / √d_k)V其中:
- Q、K、V 分别是查询矩阵、键矩阵和值矩阵
- d_k 是键向量的维度
- 除以 √d_k 可以使梯度保持稳定
工作原理
- 线性投影:将输入嵌入投影到 Q、K、V 空间
- 注意力分数:计算查询与键之间的相似度
- Softmax 归一化:将分数转换为概率
- 加权求和:用注意力权重对值进行加权
多头注意力
我们并行使用多个注意力头,而不是单一的注意力:
MultiHead(Q, K, V) = Concat(head_1, ..., head_h)W^O每个注意力头学习不同的关系:
- 头 1:句法依赖关系
- 头 2:语义关系
- 头 3:长距离依赖关系
实际应用
自注意力被广泛应用于:
- 语言翻译
- 文本生成
- 问答系统
- 代码补全
- 图像理解
核心优势
- 并行化:与 RNN 不同,它可以一次性处理整个序列
- 长距离依赖:所有位置之间都存在直接连接
- 可解释性:注意力权重展示了模型关注的重点
了解更多
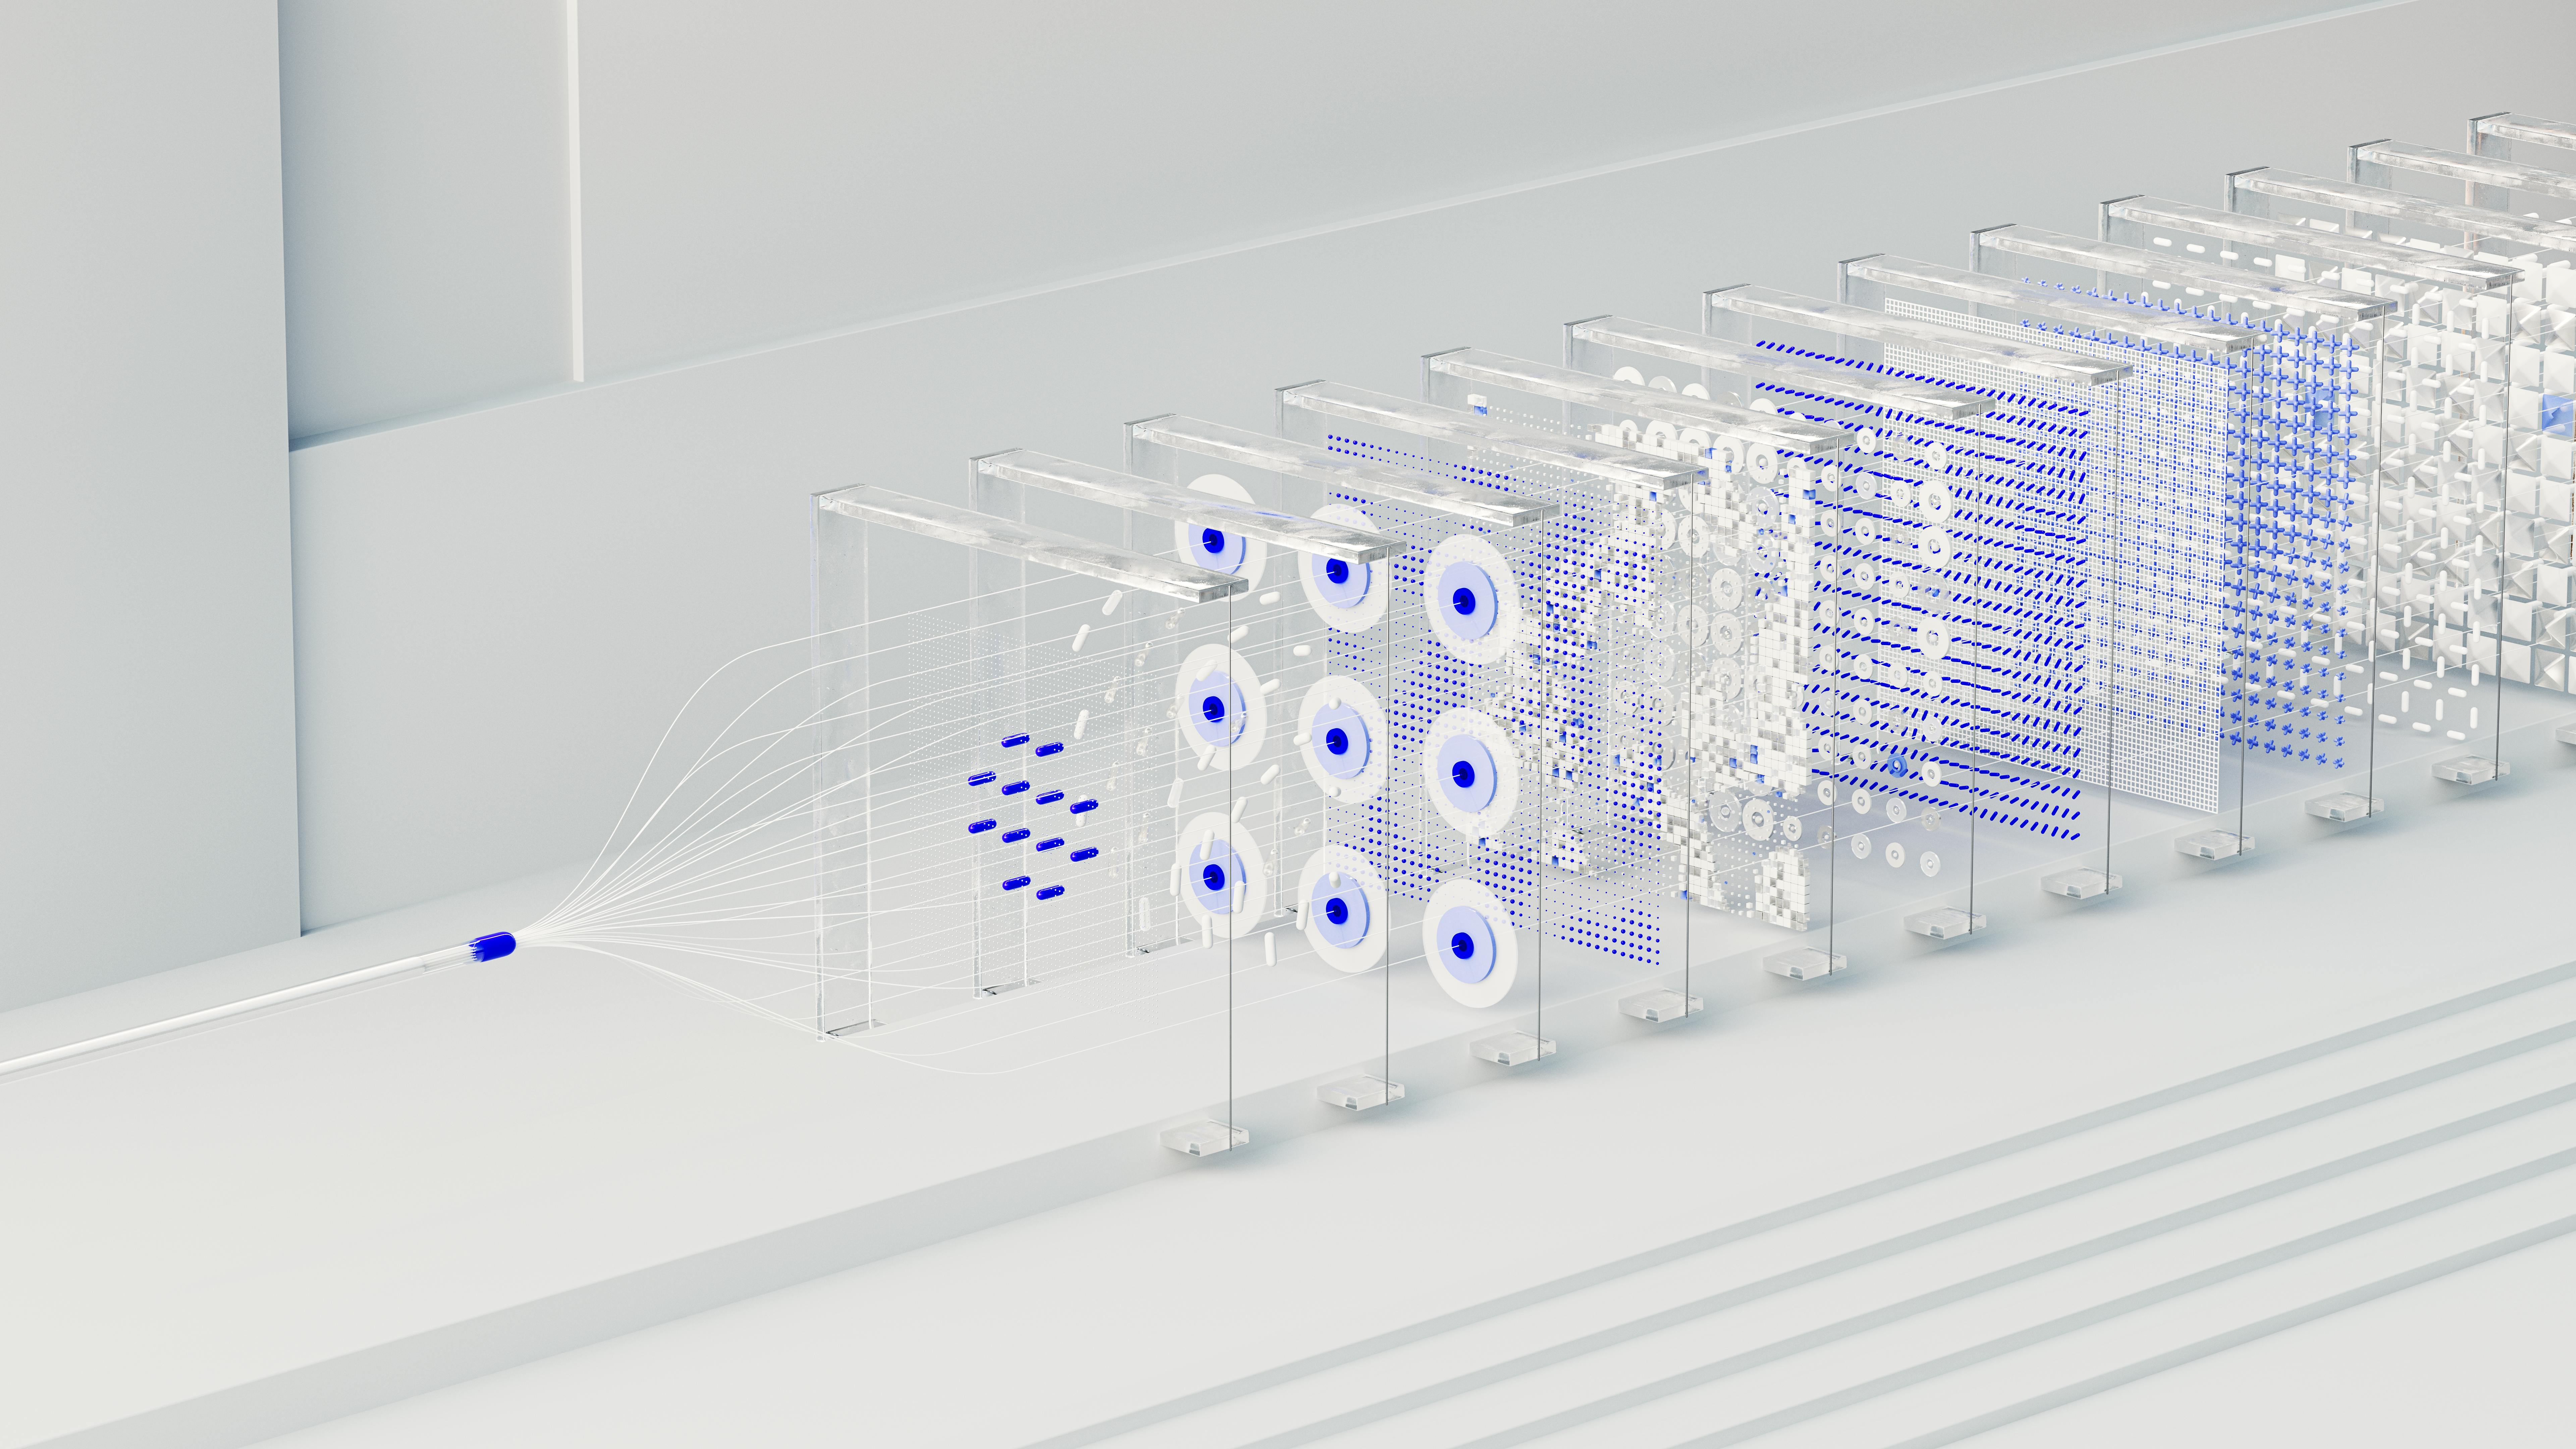
快来探索我们的交互式 3D 可视化,亲眼看看自注意力是如何运作的!